Prompt engineering para ciencia de datos: cómo pedir mejores análisis y código a la IA

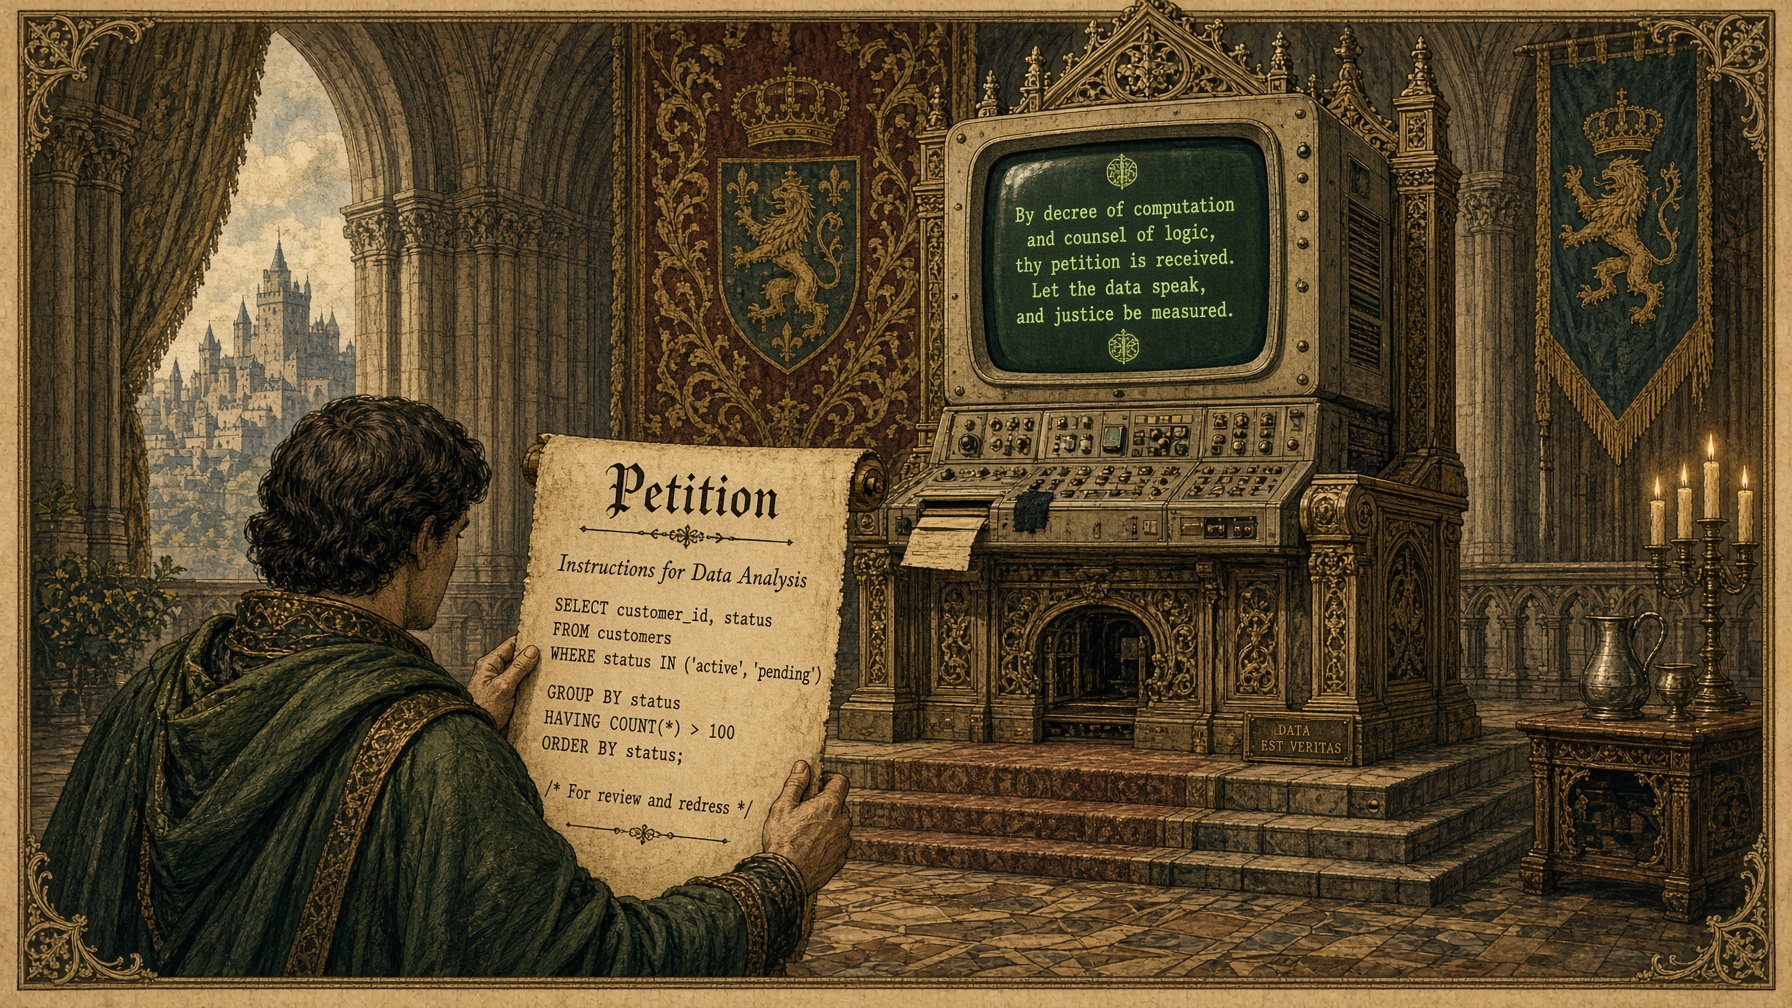
Ilustración editorial poética de estilo vintage en la que se ve a una persona desenrollando un papiro ante una computadora gigante de estilo retrofuturista. En el papel se leen instrucciones de análisis de datos, El ambiente asemeja el interior de un palacio de estilo medieval, en donde la computadora está en la posición de un noble que escucha a sus súbditos.

La inteligencia artificial ya dejó de ser el «juguete nuevo» para convertirse en una herramienta de uso cotidiano para quienes trabajamos con datos. Ya sea que necesitemos una consulta en SQL medio complicada, una transformación en Python o un análisis exploratorio, la IA nos lo entrega en cuestión de segundos. El problema es que la calidad de ese entregable depende en gran medida de cómo formulamos el pedido.

La IA rara vez admite que no puede responder adecuadamente a un prompt. Tampoco cuestiona la calidad o la facilidad de comprensión de los prompts que le enviamos. En vez de eso, siempre nos da alguna respuesta, aunque la pregunta sea confusa o esté mal formulada. Esa respuesta será código y análisis elegantes, código que funciona, pero que posiblemente no haga las cosas bien.
Un analista de datos leyendo un prompt de análisis de datos a un genio salido de una lámpara
En prompt engineering para ciencia de datos no hay palabras o frases mágicas; la clave está en dar contexto y en aplicar restricciones y criterios claros para que la IA nos dé resultados robustos, explícitos y fácilmente validables.

Puede ocurrir que arrastre supuestos incorrectos, que incluya joins dudosos o que haga interpretaciones débiles, todo lo cual incrementará la necesidad de validación de los resultados. Con un prompt adecuado y bien pensado, no eliminaremos la fase de validación, pero reduciremos mucho el esfuerzo requerido para asegurar la fiabilidad de los resultados.

Este artículo forma parte de la serie sobre ciencia de datos en la era de la IA. Aquí nos enfocamos en una habilidad práctica: cómo obtener de la IA mejores análisis y mejor código, constituyendo un complemento para el artículo sobre cómo validar el trabajo de la IA.

Leer más

Ciencia de datos en la era de la IA: qué necesita saber un científico de datos hoy

Ciencia de datos en la era de la IA – científico de datos trabajando con herramientas de inteligencia artificial

Hace unos años, cuando escribí en este blog sobre “Cómo es el trabajo de un científico de datos” y “Las 7 mejores notebooks para ciencia de datos”, el panorama era muy distinto al actual. Python y R dominaban, Jupyter era el centro del universo, y las conversaciones entre la gente de sistemas giraban en torno a modelos predictivos, feature engineering y a cómo no morir en el intento de hacer una buena limpieza de datos. La ciencia de datos con IA ya existía, pero su uso era marginal en la mayoría de los ámbitos.

Hoy, en 2026, entre las preguntas que más se escuchan (y que yo mismo me hago) está la siguiente: ¿sigue teniendo sentido aprender SQL, Python o R, o alcanza con perfeccionarse en prompts?

La respuesta corta es clara: no alcanza con prompts. La respuesta larga es más interesante y más esperanzadora para quienes vivimos de los datos.

Infografía en forma de pirámide con el stack de habilidades para ciencia de datos con IA: base de SQL y Python, machine learning, IA generativa, producción y habilidades blandas
En plena era de la IA, las habilidades fundamentales para ciencia de datos (la base de la pirámide) siguen siendo los lenguajes preferidos para manejo de datos (como SQL y Python) y los conocimientos de estadística.

El rol no desapareció, sólo se transformó

La IA generativa automatizó muchas tareas que antes consumían horas: generar código boilerplate, limpiar datasets medianos, escribir consultas SQL básicas, proponer visualizaciones e incluso entrenar modelos sencillos. Eso no eliminó al científico de datos. Cambió el centro de gravedad del trabajo.

Leer más