Ciencia de datos en la era de la IA: qué necesita saber un científico de datos hoy

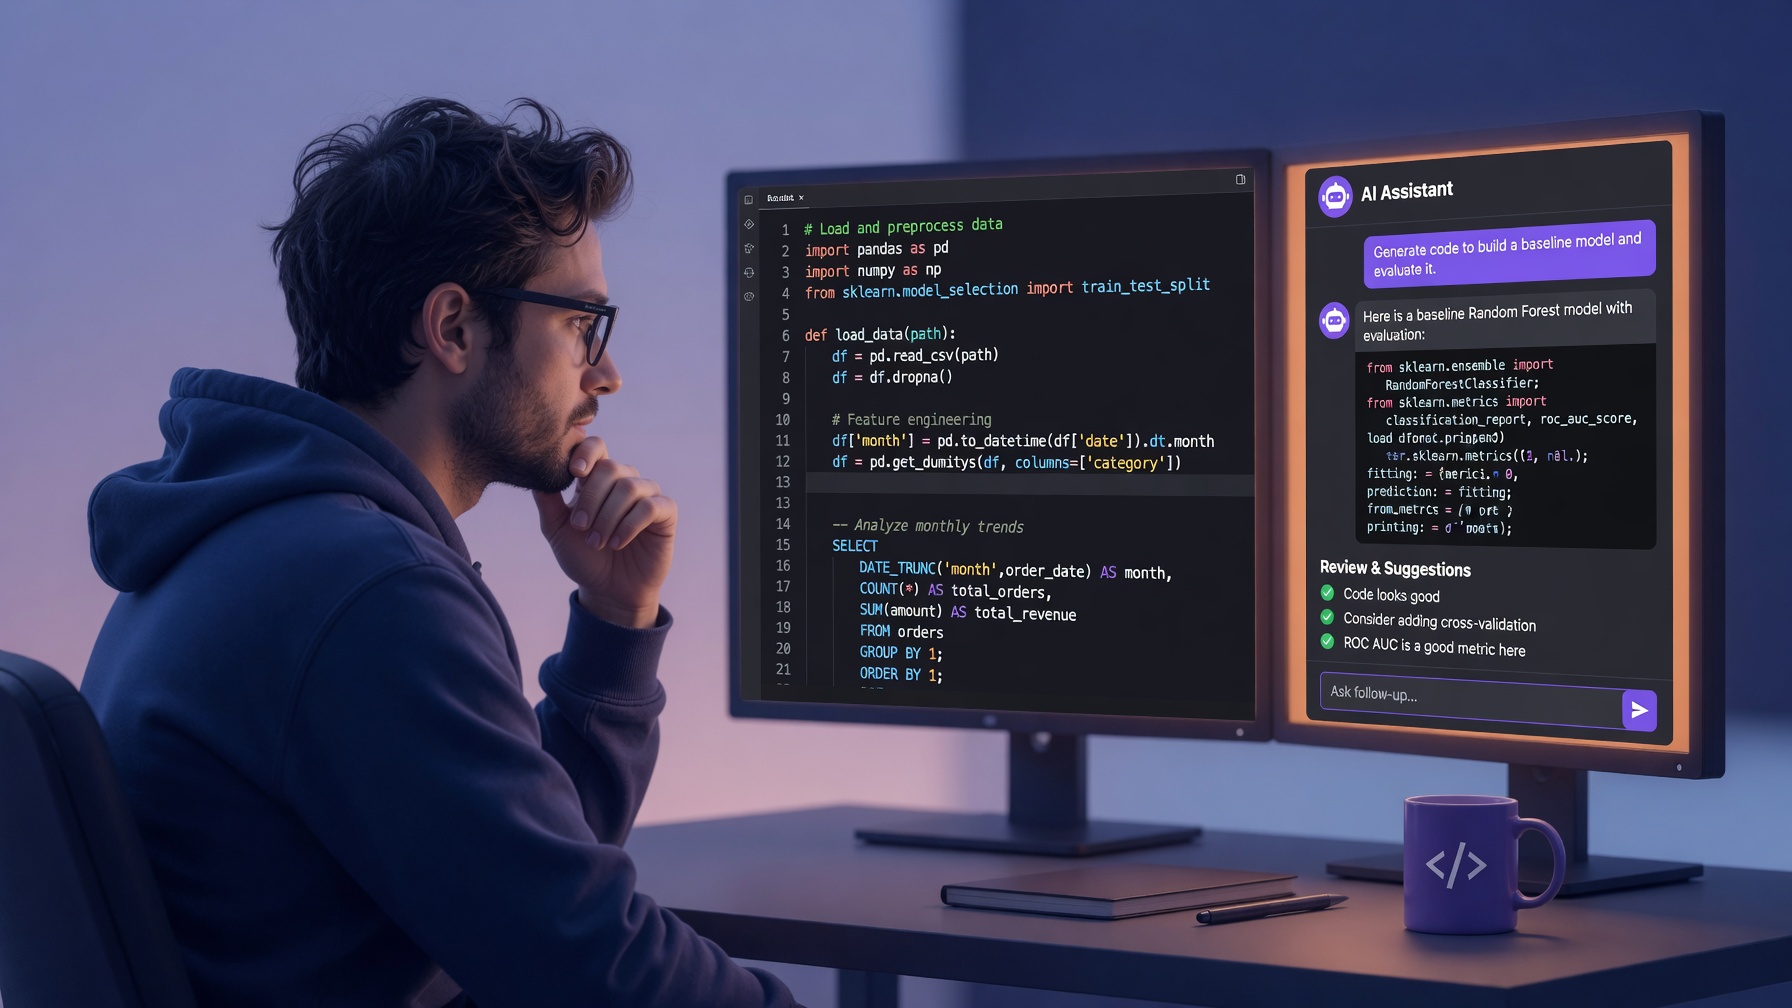
Ciencia de datos en la era de la IA – científico de datos trabajando con herramientas de inteligencia artificial

Hace unos años, cuando escribí en este blog sobre “Cómo es el trabajo de un científico de datos” y “Las 7 mejores notebooks para ciencia de datos”, el panorama era muy distinto al actual. Python y R dominaban, Jupyter era el centro del universo, y las conversaciones entre la gente de sistemas giraban en torno a modelos predictivos, feature engineering y a cómo no morir en el intento de hacer una buena limpieza de datos. La ciencia de datos con IA ya existía, pero su uso era marginal en la mayoría de los ámbitos.

Hoy, en 2026, entre las preguntas que más se escuchan (y que yo mismo me hago) está la siguiente: ¿sigue teniendo sentido aprender SQL, Python o R, o alcanza con perfeccionarse en prompts?

La respuesta corta es clara: no alcanza con prompts. La respuesta larga es más interesante y más esperanzadora para quienes vivimos de los datos.
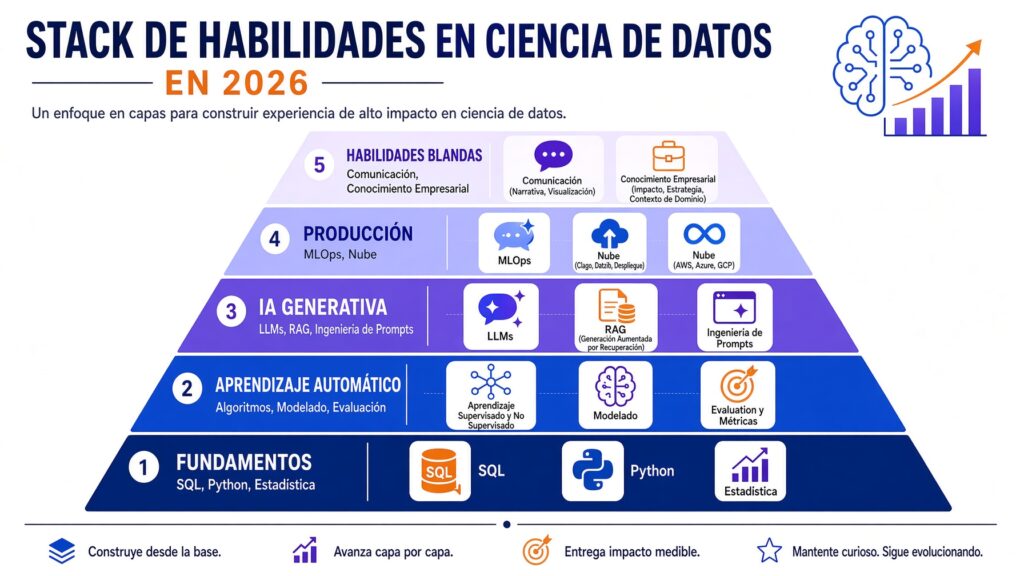
Infografía en forma de pirámide con el stack de habilidades para ciencia de datos con IA: base de SQL y Python, machine learning, IA generativa, producción y habilidades blandas
En plena era de la IA, las habilidades fundamentales para ciencia de datos (la base de la pirámide) siguen siendo los lenguajes preferidos para manejo de datos (como SQL y Python) y los conocimientos de estadística.

El rol no desapareció, sólo se transformó

La IA generativa automatizó muchas tareas que antes consumían horas: generar código boilerplate, limpiar datasets medianos, escribir consultas SQL básicas, proponer visualizaciones e incluso entrenar modelos sencillos. Eso no eliminó al científico de datos. Cambió el centro de gravedad del trabajo.

Leer más

Cómo es el trabajo de un ingeniero de Big Data

ingeniero de big data

Para transportar grupos reducidos de personas a través de distancias cortas y sin mucho apuro podrías arreglártelas conduciendo un autobús. Pero si necesitas transportar a muchas personas, a través de grandes distancias y en tiempos mínimos, deberás aprender a pilotear un avión. De seguro te será más difícil, tendrás más responsabilidades, pero te dará más satisfacciones y ganarás mucho más dinero. Esa misma diferencia es la que existe entre el trabajo de un ingeniero de datos convencional y el de un ingeniero de Big Data.

Big Data se refiere, como podrás imaginarlo, a conjuntos de datos muy grandes. La definición exacta de “muy grandes” puede variar según a quién le preguntes, pero es común que los repositorios de Big Data superen holgadamente los 10 terabytes de datos. Y es cada vez más habitual escuchar hablar de volúmenes que alcanzan el orden de los petabytes (1 petabyte = 1,024 terabytes).

Pero no se trata sólo de alto volumen. Otros atributos de Big Data incluyen amplia variedad de datos (estructurados, semiestructurados y desestructurados) y altas velocidades de procesamiento y acceso. Comúnmente se hace referencia a estas cualidades como “las tres V”: Volumen, Velocidad y Variedad. 

ingeniería de big data
Big Data no se trata sólo de gigantescos volúmenes de información. Otros de sus atributos incluyen amplia variedad de datos (estructurados, semiestructurados y desestructurados) y altas velocidades de procesamiento y acceso. Imagen: NightCafe.

A las tres «V» mencionadas arriba se les suelen agregar otras dos, para abarcar otros importantes aspectos que debe tener toda solución de Big Data: Veracidad, o confiabilidad de los datos (para evitar información incompleta, sucia o imprecisa) y Valor, refiriéndose a la importancia de extraer descubrimientos valiosos que posibiliten decisiones informadas y generen valor de negocio.

Esas particularidades hacen que un ingeniero de Big Data deba utilizar frameworks especiales, además de las herramientas que usa un ingeniero de datos convencional. Más adelante en este artículo veremos en detalle las tecnologías que debe dominar todo ingeniero de Big Data.

Leer más

El poder del Data Storytelling: contar historias con datos para liberar ideas y causar impacto

Data storytelling (imagen: Dall-E)

El data storytelling se refiere a la técnica de utilizar datos, visualizaciones y narrativas para contar historias con datos y comunicar resultados de manera efectiva. Es una manera de presentar conclusiones informadas, basadas en procesos de análisis de datos, en forma manera amena y fácil de comprender.

En el mundo actual, impulsado por los datos, cada vez es más importante la capacidad de comunicar eficazmente los conocimientos y hacer que los datos sean comprensibles. La narración de datos (o Data Storytelling), o contar historias con datos, es una poderosa técnica que combina el arte de contar historias con la ciencia del análisis de datos. Al tejer narrativas en torno a los datos, las organizaciones y los individuos pueden liberar el verdadero potencial de sus datos, lo que les permite informar, persuadir e inspirar la acción.

En este artículo, exploraremos el concepto de narración de datos, sus ventajas y consejos prácticos para elaborar narraciones convincentes basadas en datos. Comencemos por dejar claro un punto: debes encontrar una forma efectiva de exponer los resultados de tus análisis de datos, o de lo contrario tu trabajo habrá sido inútil.

Para hacer data storytelling debes echar mano de herramientas de visualización que permitan ver fácilmente patrones, tendencias y correlaciones.
Para hacer data storytelling debes echar mano de herramientas de visualización que permitan ver fácilmente patrones, tendencias y correlaciones (imagen: Dall-E 2).

Presentar datos y resultados de una forma efectiva es una tarea que dista mucho de ser trivial. Y puede ser también bastante difícil para quienes lidiamos en forma cotidiana con números fríos y no necesitamos visualizaciones o narrativas para comprenderlos.

Las narraciones basadas en datos tienen el potencial de captar la atención, simplificar información compleja y evocar respuestas emocionales, lo que conduce a una mejor comprensión y toma de decisiones.

Cuando los números no hablan por sí mismos

Darles a los números una voz para que hablen por sí mismos es una de las tareas del científico de datos o del analista de datos. Esta tarea consiste en llenar la brecha que separa al frío mundo de los números crudos del caliente y vertiginoso mundo de los negocios. Para llenar esa brecha hay que echar mano de herramientas que expongan claramente patrones, tendencias y correlaciones.

Leer más